
📝 本系列為 iThome 鐵人賽學習筆記,屬個人教學與非商業用途;文中法規與標準內容均以自身理解後的話轉述並註明出處,非逐字引用。
階段四|怎麼落地:從技術棧示範
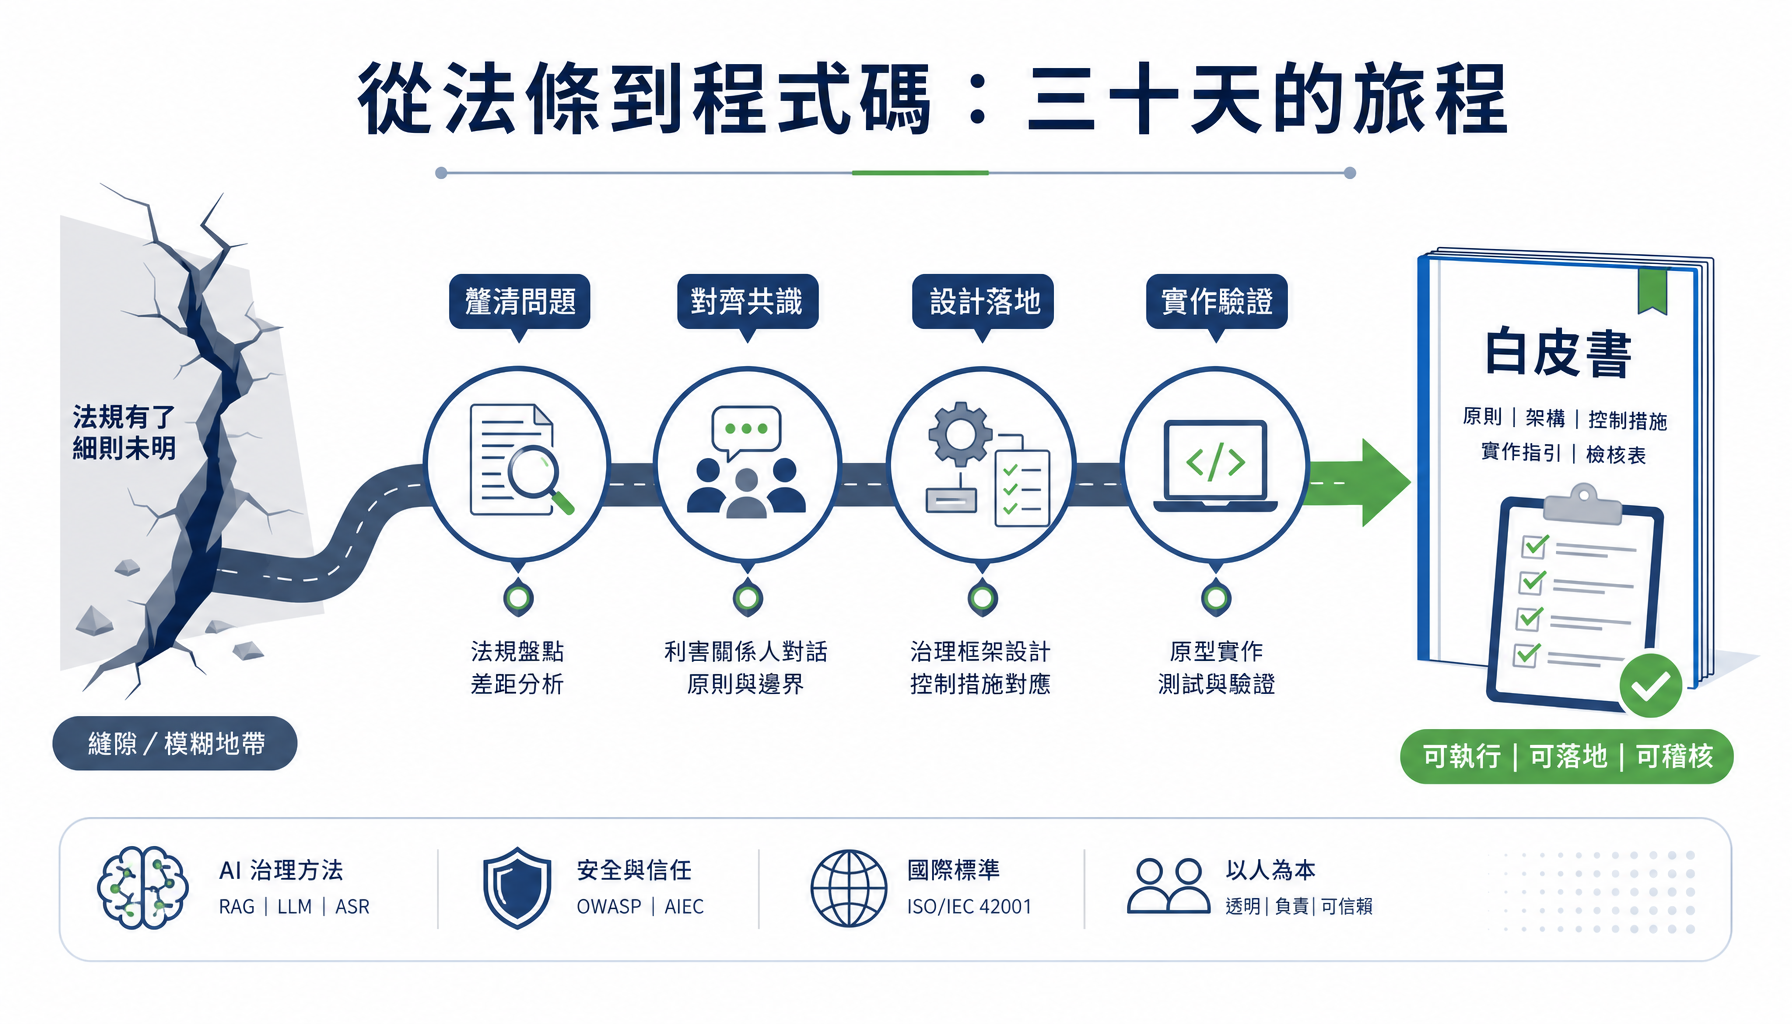
三十天前,這個系列從一個很具體的困境開始(Day 1):人工智慧基本法通過了,但真正規範「你該怎麼做」的各部會作用法還沒到位——開發者卡在一條「法律有了、細則未明」的縫隙裡,不知道手上的 AI 專案到底該符合什麼、又該怎麼證明自己合規。
整個系列要回答的,就是這個困境。而回答的方式,濃縮成一句話,就是本系列的標題——「從法條到程式碼」:把最上層那些抽象的法規與標準,一層一層往下翻譯,最後變成一行行跑得起來的程式、一份份拿得出手的證據。
今天是最後一天。我們要做三件事:回望這條貫穿三十天的路、把成果合成一份可再利用的白皮書、並留下一個持續追蹤的觀察點。
這三十天,沿著「從法條到程式碼」的方向,走過了如下圖所示的四個階段:
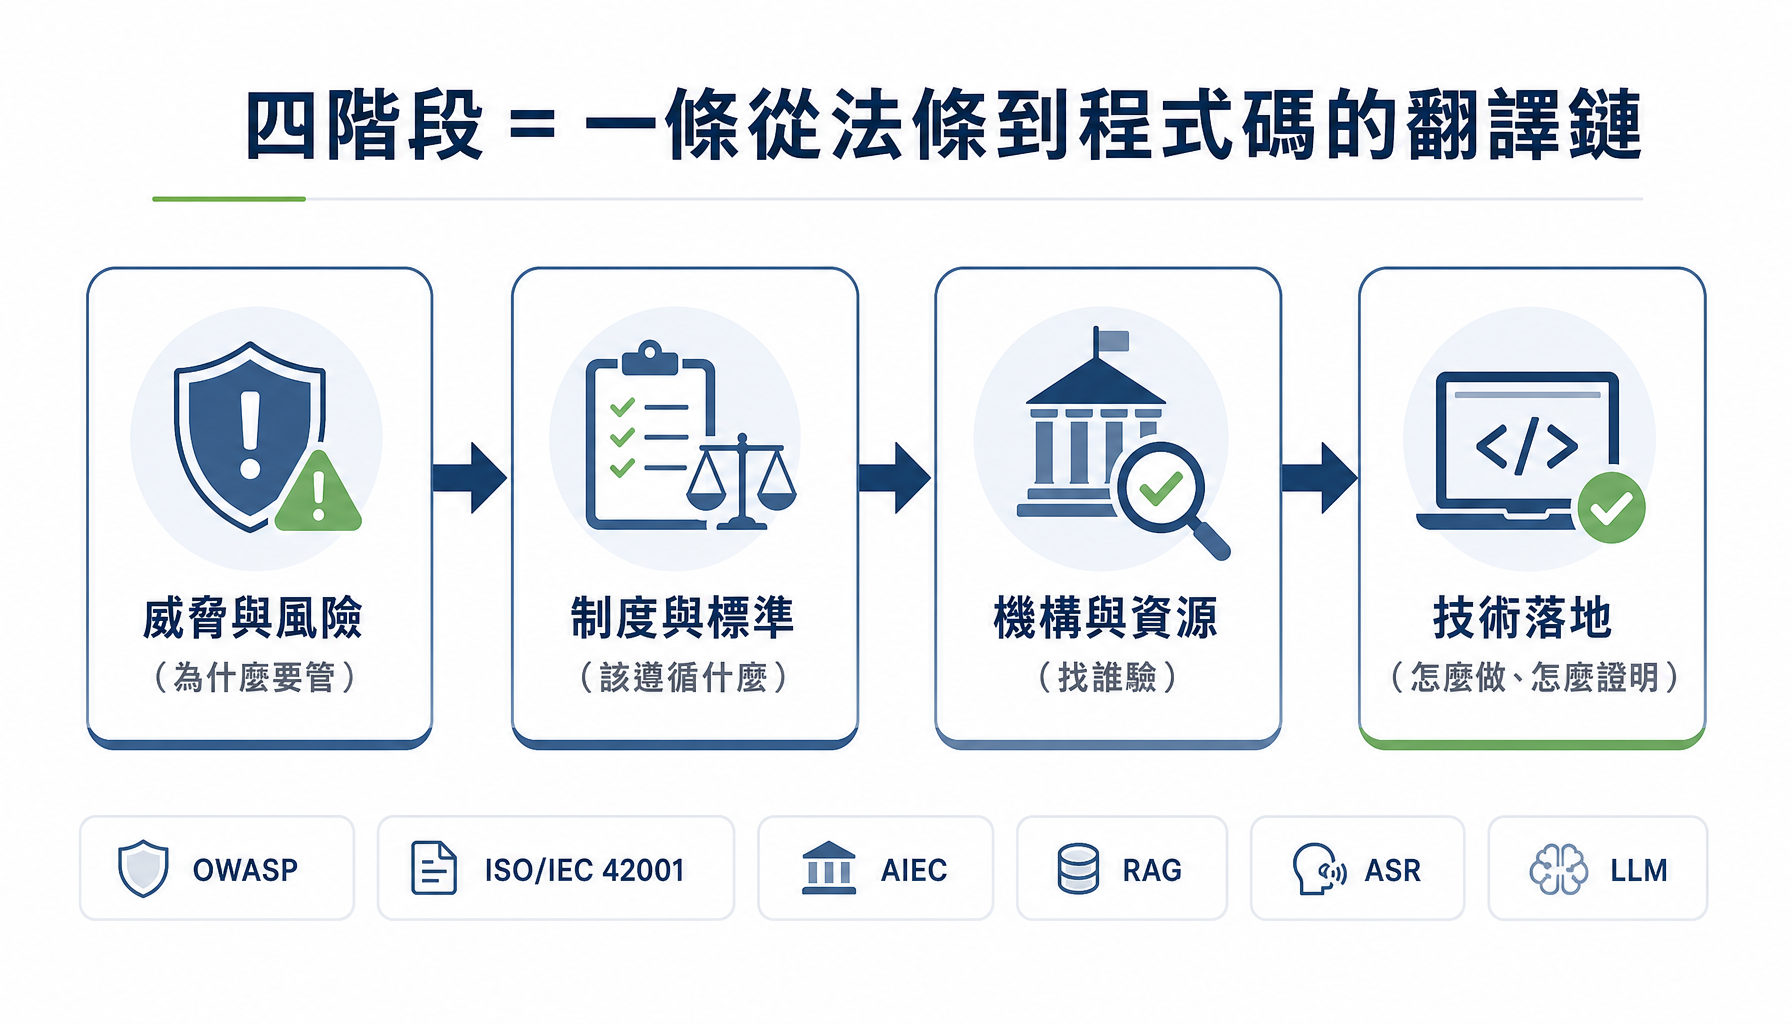
四個階段,正好是一條完整的翻譯鏈:威脅(為什麼要管)→ 制度(該遵循什麼)→ 機構(找誰驗)→ 技術(怎麼做、怎麼證明)。 這條鏈,就是「從法條到程式碼」的全貌。
如果要把三十天濃縮成幾條最重要的原則——那些不管做哪一層、都反覆出現的「紀律」——會是如下圖所示的五條:
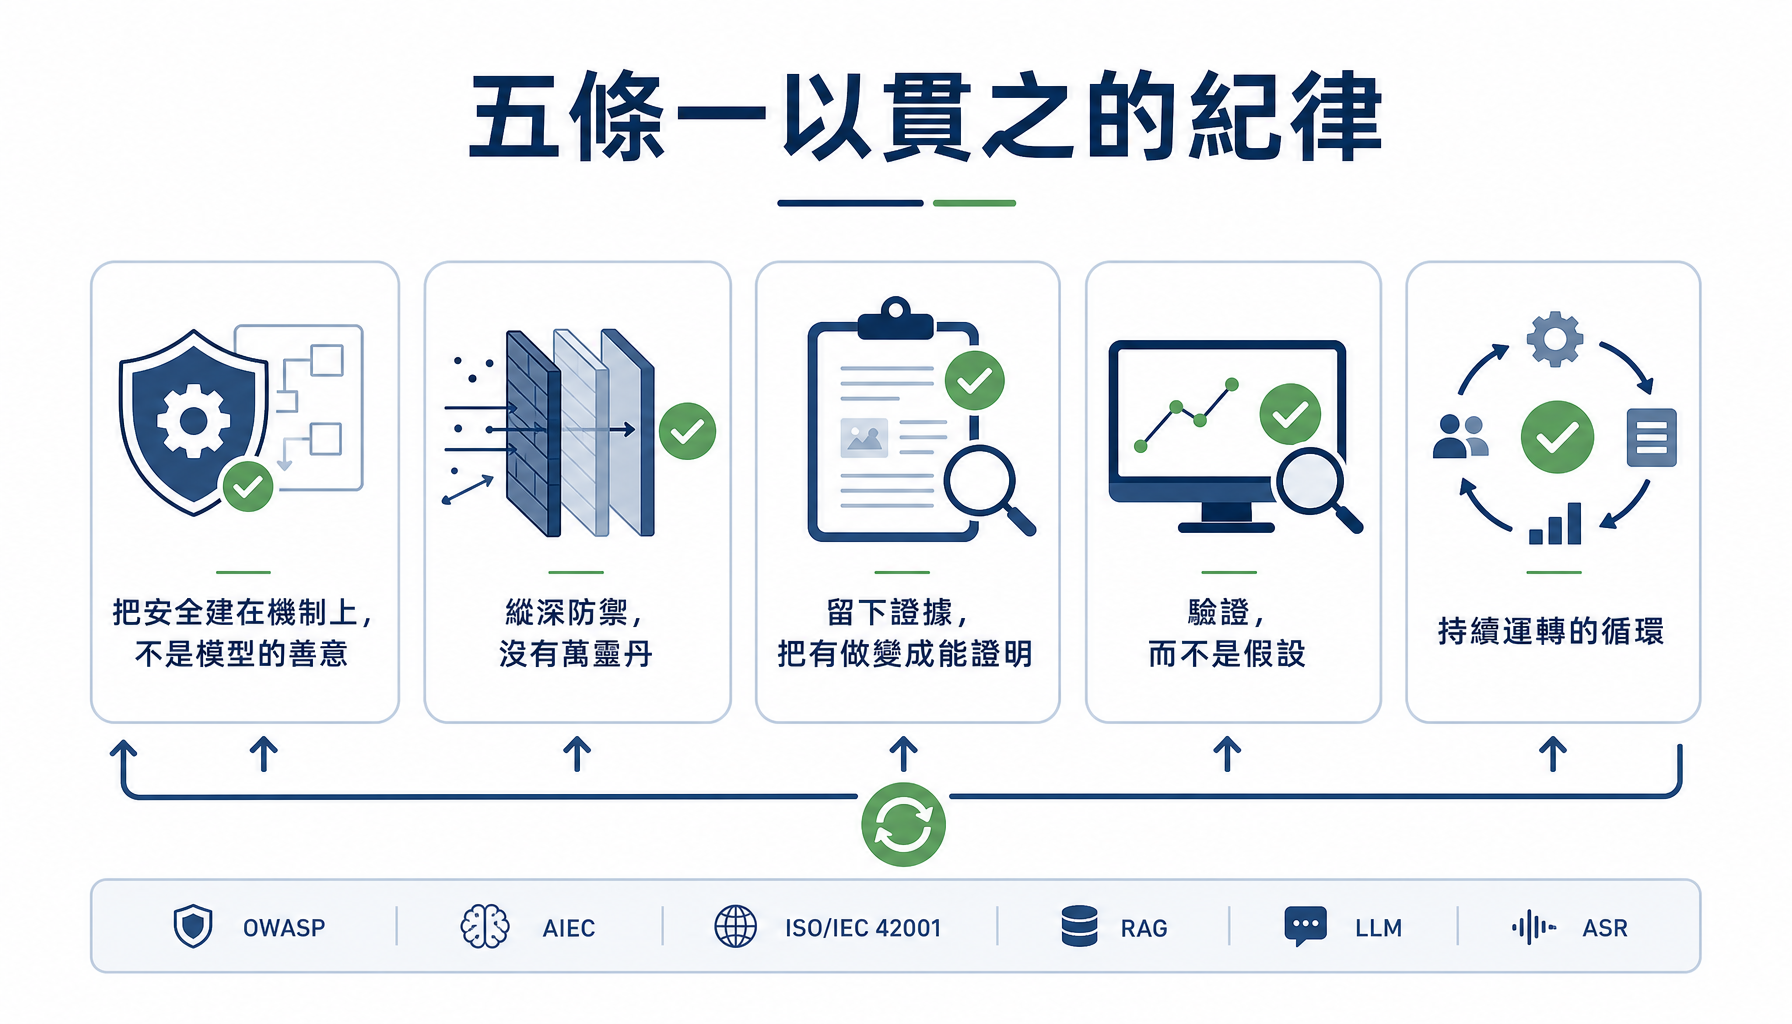
這五條,比任何單一技術都重要——因為技術會過時,但這些紀律不會。
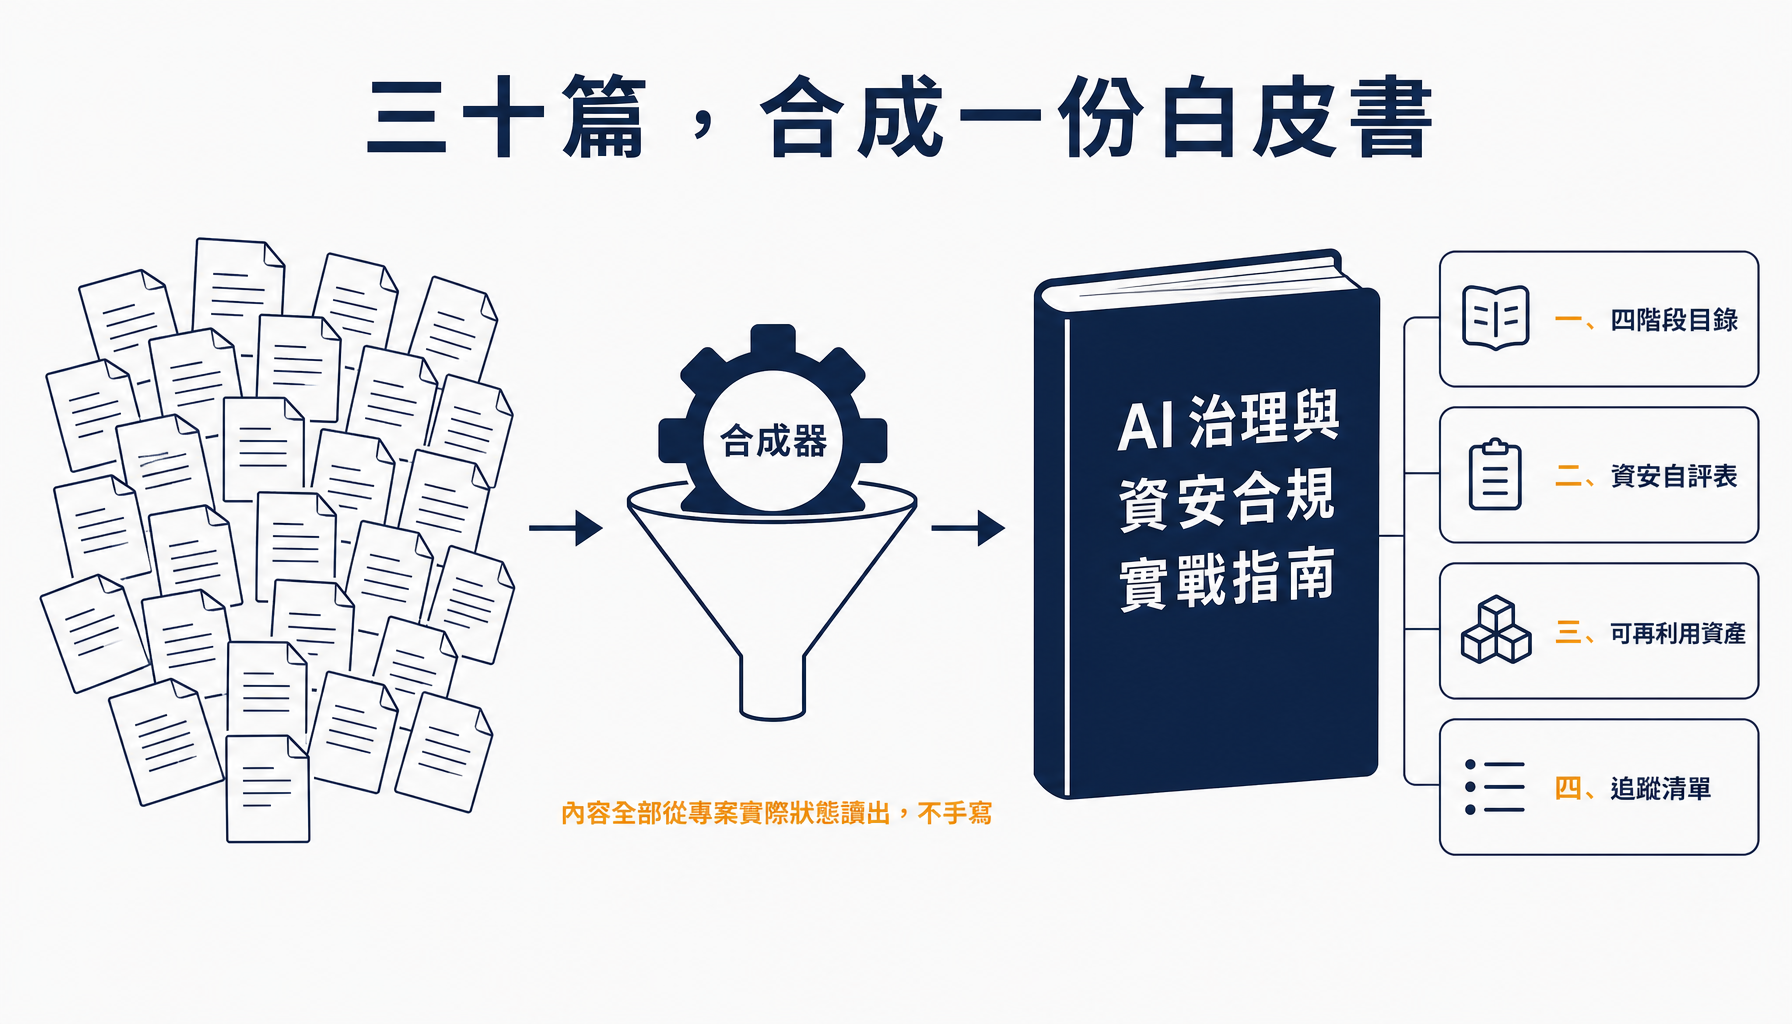
最後一個技術動作,是把這三十天散落的成果,合成一份可交付、可再利用的白皮書(完整檔在 程式碼/Day30/build_whitepaper.py)。
這支合成器有一條刻意的設計原則,值得先講:白皮書裡沒有任何一個數字、任何一格內容是手寫的。 全部從專案的實際狀態讀出來。理由很現實——手寫的摘要一定會過期。今天抄一份檢核表進去,明天改了檢核表,白皮書就悄悄變成錯的,而且沒有人會發現。所以合成器寧可去讀原始檔案,也不自己存一份副本。
先是匯入與兩個常數——ROOT 指向專案根目錄,STAGES 則是四階段的分界:
import glob
import os
import re

# 專案根目錄(本檔在 程式碼/Day30/,往上三層即根)
ROOT = os.path.dirname(os.path.dirname(os.path.dirname(os.path.abspath(__file__))))
HERE = os.path.dirname(os.path.abspath(__file__))

# 四階段的分界(起日、迄日、名稱)
STAGES = [
    (1, 5, "第一階段|威脅與風險"),
    (6, 14, "第二階段|制度與標準"),
    (15, 20, "第三階段|機構與資源"),
    (21, 30, "第四階段|技術落地"),
]
接著是核心邏輯,很單純:讀每一篇 DayNN.md 的第一行標題,依 STAGES 的分界歸類:
def read_title(day: int) -> str:
    """從 DayNN.md 第一行 '# Day NN:標題' 抽出標題。"""
    path = os.path.join(ROOT, f"Day{day:02d}.md")
    if not os.path.exists(path):
        return "(未完成)"
    first = open(path, encoding="utf-8").readline().strip()
    m = re.match(r"#\s*Day\s*\d+[::]\s*(.+)", first)
    return m.group(1) if m else "(無標題)"
read_title() 用一行正規表示式(Regular Expression,一種文字比對規則,見 Day 22),把每篇文章第一行的標題抽出來。這也呼應了一個小道理——因為一路遵守「檔案從 # Day NN:標題 開始」的規範,收尾時才能這樣自動化地把它們收攏起來。 一致的紀律,讓後續的自動化成為可能。
白皮書的第二節是它真正的價值所在——那份《AI 系統資安自評表》。合成器不重打,而是直接去讀 Day 29 那支查核工具的產出:
def read_self_assessment() -> str:
    """讀入 Day 29 產出的自評表;沒有就提示先去跑那支程式。"""
    path = os.path.join(ROOT, "程式碼", "Day29", "自評表.md")
    if not os.path.exists(path):
        return "> ⚠️ 尚未產出自評表,請先執行 `程式碼/Day29/compliance_checklist.py`。"
    body = open(path, encoding="utf-8").read()
    # 去掉自評表自己的大標,只留說明與表格,避免白皮書出現兩層標題
    kept = [ln for ln in body.splitlines() if not ln.startswith("# ")]
    return "\n".join(kept).strip()
這幾行看起來平淡,但它讓整條鏈接了起來:改一次 assessment.json → 重跑 Day 29 → 重跑這支合成器 → 白皮書自動更新。 白皮書從此不是一份靜態文件,而是專案狀態的一個投影。
第三節是可再利用資產。這裡同樣不寫死數量,而是實際去數:
def count_assets() -> dict:
    """實際清點可再利用的資產數量,而不是宣稱。"""
    return {
        "程式": len(glob.glob(os.path.join(ROOT, "程式碼", "Day*", "*.py"))),
        "配圖": len(glob.glob(os.path.join(ROOT, "圖檔", "Day*", "*.png"))),
        "知識庫": len(glob.glob(os.path.join(ROOT, "程式碼", "Day*", "knowledge*", "*.md"))),
    }
這呼應了 Day 29 那條規則——不相信宣稱,只相信檔案。 白皮書說有十七支程式,是因為真的數到十七個 .py 檔。
第四節是這次新增、也是最實用的一節。與其在結尾寫一句「請定期更新」,不如直接寫成一張表:追什麼、去哪裡看、什麼時候該回頭、要改白皮書的哪一格。
# 追蹤清單:這份白皮書會因為什麼而過期,該去哪裡看
WATCHLIST = [
    ("各部會 AI 作用法與指引", "國家科學及技術委員會、各目的事業主管機關",
     "新指引發布時", "檢核表的「制度來源」欄"),
    ("資安法規與採購要求", "數位發展部資通安全署、行政院公共工程委員會",
     "法規修正時", "Day 20 的責任等級與通報義務"),
    # …… 其餘三項即下文「後續追蹤」一節那張表的後三列 ……
]
把它寫進程式而不是寫在文章結尾,是為了讓它跟著白皮書一起被產出、一起被看見。
最後由 build() 把四節依序串成一份 Markdown,__main__ 負責寫檔並印出摘要:
def build() -> str:
    """合成白皮書 Markdown,回傳字串。"""
    lines = [
        "# 《AI 治理與資安合規實戰指南》白皮書",
        "",
        "> 由 iThome 鐵人賽 30 天系列合成。把上層法規標準,一路翻譯到可執行的技術控制與程式碼。",
        "> 本文件由 `程式碼/Day30/build_whitepaper.py` 自動產生,內容隨專案實際狀態更新。",
        "",
        "## 一、目錄:從法條到程式碼的四階段",
        "",
    ]
    for start, end, name in STAGES:
        lines.append(f"### {name}(Day {start}–{end})")
        for day in range(start, end + 1):
            lines.append(f"- Day {day:02d}:{read_title(day)}")
        lines.append("")

    lines += ["## 二、核心交付物:AI 系統資安自評表", "",
              "以下直接引用 Day 29 查核工具的產出,每一格佐證都經過存在性驗證。", "",
              read_self_assessment(), ""]

    assets = count_assets()
    lines += ["## 三、可再利用資產", "",
              f"- 可執行程式 {assets['程式']} 支:RAG 五層防禦、紅隊框架、"
              f"稽核日誌、供應鏈驗證、合規查核工具(`程式碼/DayNN/`)",
              f"- 概念與流程配圖 {assets['配圖']} 張(`圖檔/DayNN/`)",
              f"- 教學用知識庫文件 {assets['知識庫']} 份(`程式碼/DayNN/knowledge*/`)",
              "- 適用場景:醫院 AI 客服案、政府 AI 標案的自評、送測與稽核。", ""]

    lines += ["## 四、追蹤清單:這份文件何時該回頭修", "",
              "| 追什麼 | 去哪裡看 | 什麼時候回頭 | 要改白皮書哪裡 |",
              "| --- | --- | --- | --- |"]
    for what, where, when, fix in WATCHLIST:
        lines.append(f"| {what} | {where} | {when} | {fix} |")
    lines.append("")
    return "\n".join(lines)


if __name__ == "__main__":
    whitepaper = build()
    out = os.path.join(HERE, "白皮書.md")
    with open(out, "w", encoding="utf-8") as f:
        f.write(whitepaper)

    done = sum(1 for d in range(1, 31) if read_title(d) not in ("(未完成)", "(無標題)"))
    assets = count_assets()
    print(f"✅ 已合成白皮書 → {os.path.basename(out)}({len(whitepaper)} 字元)")
    print(f"   收錄文章:{done}/30 篇")
    embedded = os.path.exists(os.path.join(ROOT, "程式碼", "Day29", "自評表.md"))
    print(f"   嵌入 Day 29 自評表:{'是' if embedded else '否(請先跑 Day 29)'}")
    print(f"   清點資產:程式 {assets['程式']} 支、配圖 {assets['配圖']} 張、"
          f"知識庫 {assets['知識庫']} 份")
    print(f"   追蹤清單:{len(WATCHLIST)} 項")
    print("\n── 白皮書目錄預覽 ──")
    for start, end, name in STAGES:
        print(f"  {name}(Day {start}–{end})")
build() 這幾十行,正是前面那句「沒有任何數字是手寫的」的證明:目錄來自 read_title()、自評表來自 read_self_assessment()、資產數量來自 count_assets()——每一格都是讀出來的,沒有一格是打上去的。
把工具跑起來(python build_whitepaper.py),終端輸出如下:
✅ 已合成白皮書 → 白皮書.md(3095 字元)
   收錄文章:30/30 篇
   嵌入 Day 29 自評表:是
   清點資產:程式 21 支、配圖 167 張、知識庫 9 份
   追蹤清單:5 項

── 白皮書目錄預覽 ──
  第一階段|威脅與風險(Day 1–5)
  第二階段|制度與標準(Day 6–14)
  第三階段|機構與資源(Day 15–20)
  第四階段|技術落地(Day 21–30)
(資產數量是執行當下數出來的,所以每次新增程式或配圖,重跑一次就會不一樣——這正是它的設計目的。)
一份完整的 白皮書.md 就生成了,四節俱全:依四階段編排的三十篇目錄、Day 29 那份每格佐證都經過查核的自評表、清點過的可再利用資產、以及一份追蹤清單。這份文件,就是整個系列真正的最終交付物:不是三十篇要人一篇篇讀的文章,而是一份能拿在手上、翻得動、用得上的白皮書。
這份白皮書與檢核表,不是鐵人賽結束就作廢的作業,它是一份能落到真實場景的資產。如下圖所示,它有兩個再利用場景:
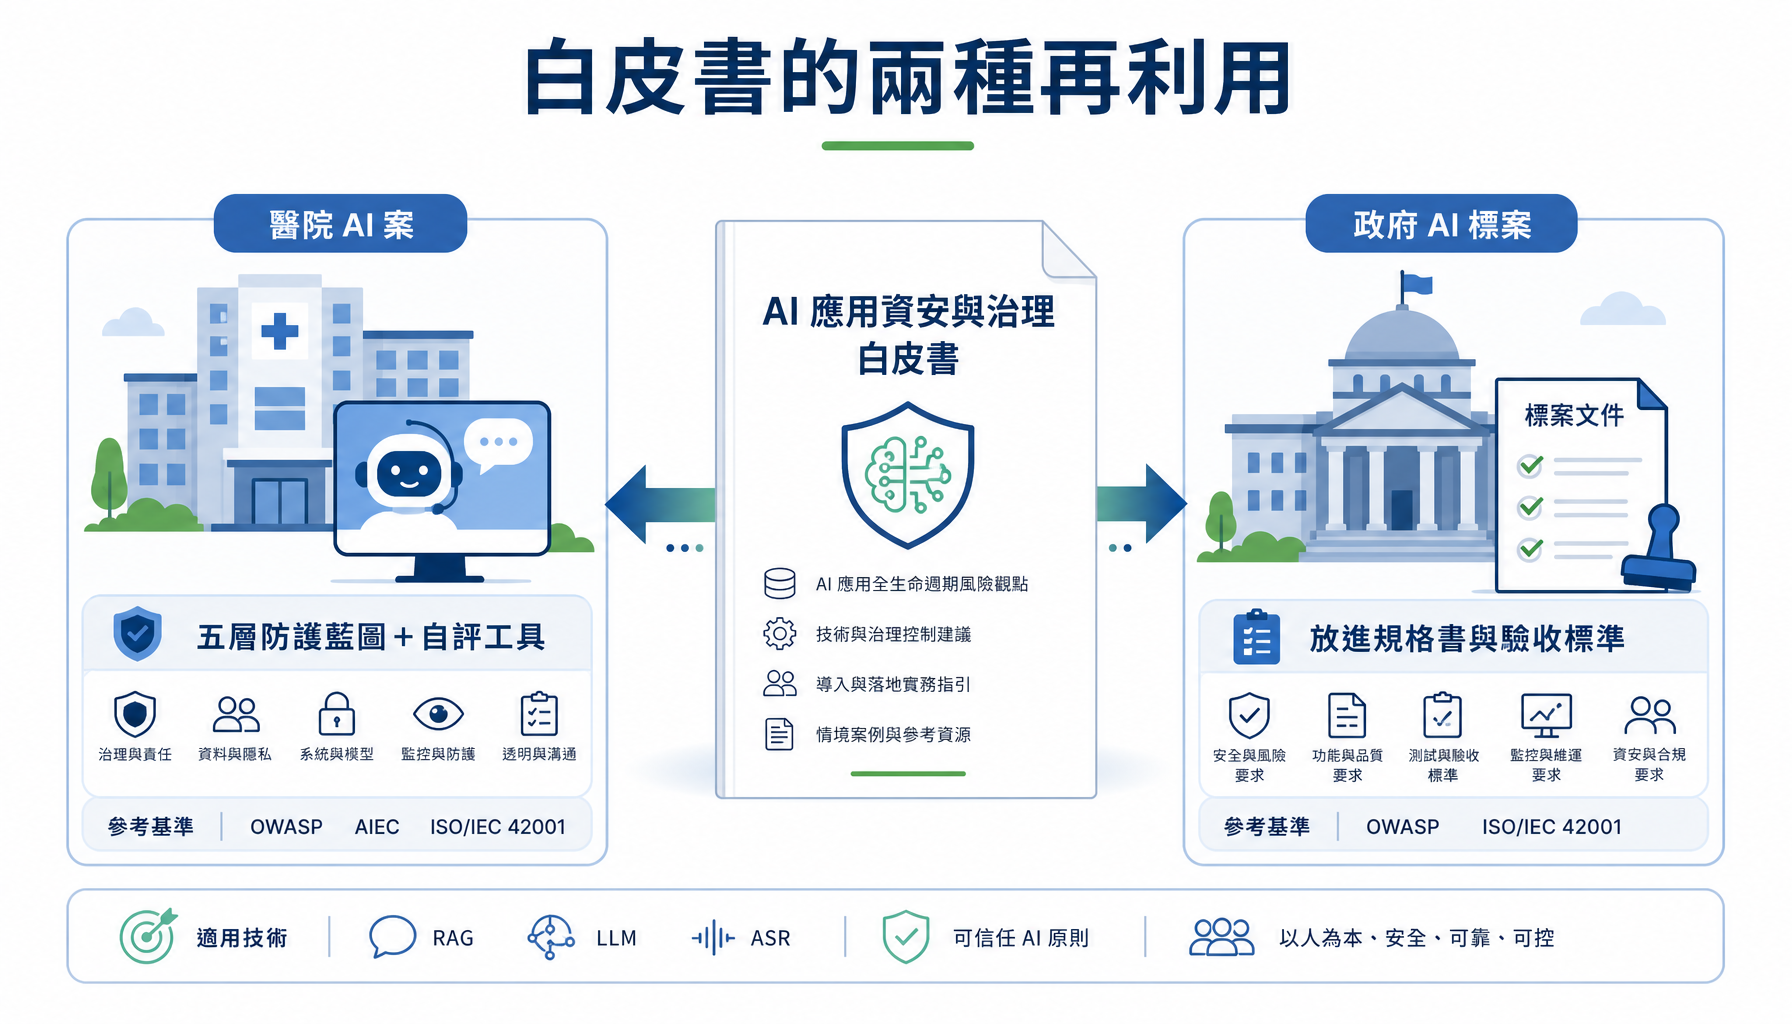
換句話說,三十天的成果不只是「學會了」,而是留下了一套可以重複使用的方法論與工具——換一個專案、換一個場景,把靶機換掉、把檢核表的落實狀態重填,這套流程就能再跑一遍。
最後,必須誠實地留下一個提醒:這份白皮書,不是一份「完成」的文件,而是一份「活的」文件。
本系列反覆強調過,台灣的 AI 治理正在滾動式地成形:人工智慧基本法雖已通過,但各部會的作用法、細則、指引仍在陸續發布;AIEC 的評測項目、ISO/CNS 標準也都可能改版;而攻擊手法更是天天在演化。
問題是,「要定期更新」這句話講起來容易,執行起來卻沒有著力點——更新什麼?去哪裡看?改哪裡?所以合成器把它寫成了一張具體的追蹤清單,隨白皮書一起產出:
| 追什麼 | 去哪裡看 | 什麼時候回頭 | 要改白皮書哪裡 |
|---|---|---|---|
| 各部會 AI 作用法與指引 | 國家科學及技術委員會、各目的事業主管機關 | 新指引發布時 | 檢核表的「制度來源」欄 |
| 資安法規與採購要求 | 數位發展部資通安全署、行政院公共工程委員會 | 法規修正時 | Day 20 的責任等級與通報義務 |
| AIEC 評測項目 | 數位產業署 AI 產品與系統評測中心 | 評測項目調整時 | 檢核表的十列骨架 |
| ISO/IEC 42001 與 CNS 42001 | ISO、經濟部標準檢驗局 | 標準改版時 | 檢核表的「42001 落點」欄 |
| 新型攻擊手法 | OWASP LLM Top 10、資安社群 | 出現新手法時 | Day 26 的紅隊案例庫 |
這張表的用法很單純:每一列都是一組「訊號 → 動作」。 看到訊號(例如衛福部發布了醫療 AI 指引),就知道要動白皮書的哪一格(檢核表的制度來源欄),而不必重讀三十篇文章去想哪裡受影響。這比一句「請保持關注」有用得多。
至於複查頻率,實務上的建議是:跟著專案的節奏走——每次要投標、送測或做內部稽核之前,把這張表過一遍;沒有這些觸發事件時,至少每半年一次。
「邊做邊追」——追一個還在成形中的活議題——正是這個題目最長期的價值所在。三十天不是終點,而是替後續的持續追蹤,打下了一個有結構、有工具、有紀律的起點。
最後把這支工具的邊界說清楚:
換句話說,這支工具處理的是「不要讓文件跟現實脫節」這件事——這已經是很多合規文件做不到的了,但它終究只是把人的判斷保存下來,不能取代那個判斷。
三十天前,我們站在一條「法律有了、細則未明」的縫隙前,感到無所適從。三十天後,這條縫隙沒有完全消失——它本來就需要時間,靠整個生態一起把它補起來——但我們手上,已經多了一份東西:一張把抽象法規一路翻譯到具體程式碼的地圖,和一套能拿去用、能持續更新的工具。
從 Day 1 的一條法規縫隙,到 Day 30 的一份可執行白皮書,這趟「從法條到程式碼」的旅程,到這裡告一段落。法規會繼續更新、技術會繼續演化,但這套「把上層要求翻譯成下層控制、再用證據證明它」的方法,會一直有用。
感謝每一位讀到這裡的讀者。願這份白皮書,能成為你手上那個 AI 專案,真正用得上的起點。
程式碼/Day30/build_whitepaper.py(白皮書合成器)與其產出 程式碼/Day30/白皮書.md。程式掃描本系列 30 篇文章標題、依四階段整理,並嵌入 Day 29 核心檢核表,結果為真實執行輸出。


 iThome鐵人賽
 看影片追技術